Tecnologia per la generazione dei sottotitoli

Come Weydub genera sottotitoli sincronizzati dai video con OCR e ASR

I sottotitoli destinati alla produzione non sono una trascrizione a cui vengono aggiunti i timestamp in un secondo momento. Weydub utilizza due flussi di lavoro indipendenti: l'OCR temporale sui video per il testo già impresso nell'immagine e l'ASR ottimizzato per i sottotitoli per i dialoghi presenti solo nell'audio.

98.25%Accuratezza dei caratteri rilevati dall'OCR
98.92%Recall rigoroso dei cue
300K+Episodi di short drama elaborati ogni giorno
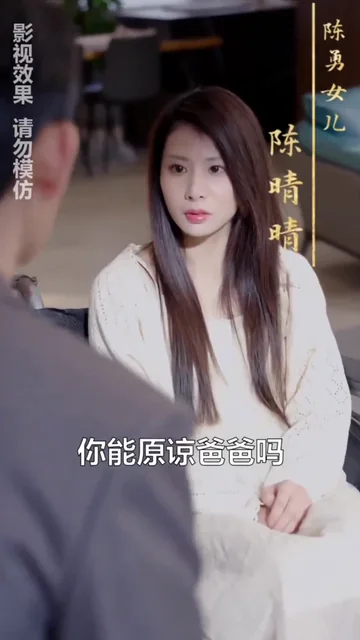
Analisi della sorgente in tempo reale OCR VIDEO / SRT
DIALOGHI / MANTIENI DISCLAIMER / ESCLUDI SCHEDA DEL PERSONAGGIO / ESCLUDI
OUTPUT MODIFICABILESRT
BATTUTA

Puoi perdonare papà?

Battuta di dialogomantenuta
Testi in sovrimpressione nelle sceneesclusi

Un singolo fotogramma sorgente può contenere diverse classi di testo leggibile. Solo il dialogo entra nella timeline dei sottotitoli.

Demo reale di un microdramma disponibile al pubblico, utilizzata per spiegare la classificazione dei sottotitoli. I diritti sui contenuti sottostanti restano al titolare dei contenuti.

Benchmark di microdrammi con lo stesso titolo

L’accuratezza conta soprattutto là dove gli operatori ne percepiscono l’impatto: la timeline delle battute

Weydub ha valutato la propria pipeline OCR per sottotitoli impressi confrontandola con una baseline ASR testata basata esclusivamente sull’audio, su un set di validazione composto da microdrammi con lo stesso titolo, utilizzando come riferimento di verità sottotitoli editoriali revisionati da persone.

Cosa misuraUn confronto tra flussi di lavoro basati su riferimenti sottotitoli, non una media open source né un benchmark universale del WER per l’ASR. La baseline audio ha utilizzato ElevenLabs Scribe v2 su voci separate.

Spiegazione tecnica

Come funziona la generazione dei sottotitoli con l'IA: OCR video vs ASR

Segui i due percorsi indipendenti del segnale, dal video sorgente a un file SRT temporizzato e modificabile, quindi scopri perché la precisione a livello di cue conta più di un singolo punteggio di riconoscimento.

Scegli la fonte più solida

Un video può contenere due diverse fonti di riferimento

Usa l'OCR quando il video contiene già sottotitoli impressi affidabili. Usa l'ASR quando il dialogo è presente nell'audio, ma non è visibile alcun testo dei sottotitoli utilizzabile.

I drama brevi rendono evidente la differenza. Musica, effetti, accenti, pianti, urla, sussurri, voci sovrapposte e dialoghi colloquiali possono interferire con il riconoscimento vocale. Una traccia di sottotitoli montata professionalmente è spesso una rappresentazione più fedele del dialogo inteso.

OCR / 01

Leggi l'indizio editoriale nell'immagine

Ideale per sottotitoli incorporati, didascalie e testo dei dialoghi visibile. La difficoltà principale consiste nel trasformare i rilevamenti ripetuti nei fotogrammi in un'unica linea temporale stabile, escludendo al contempo il testo della scena.

  • Elaborazione automatica delle regioni e degli intervalli temporali
  • Aggregazione temporale tra i fotogrammi
  • Filtraggio del testo della scena e correzione conservativa
ASR / 02

Trasforma il parlato in sottotitoli, non in paragrafi

Ideale quando la colonna sonora è l'unica fonte del dialogo. Il riconoscimento è solo il primo passo; l'individuazione leggibile dei sottotitoli, la sincronizzazione temporale, la lunghezza delle righe e i cambi di interlocutore determinano se il risultato è utilizzabile.

  • Riconoscimento vocale con la temporizzazione delle parole
  • Segmentazione semantica e acustica
  • Rilevamento opzionale dei parlanti, quando supportato

OCR video

L'OCR delle immagini vede i fotogrammi. Un sistema di sottotitolazione comprende il tempo.

A 30 fps, un minuto di video contiene 1800 fotogrammi. Eseguire un OCR generico separatamente su ogni fotogramma ripete il lavoro e restituisce riquadri di testo duplicati. Un prodotto per la sottotitolazione video deve collegare queste osservazioni in eventi temporizzati.

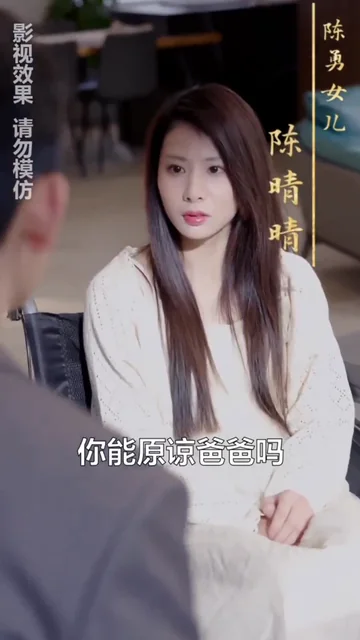
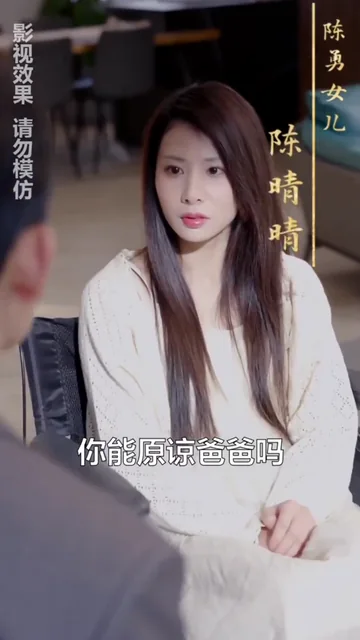
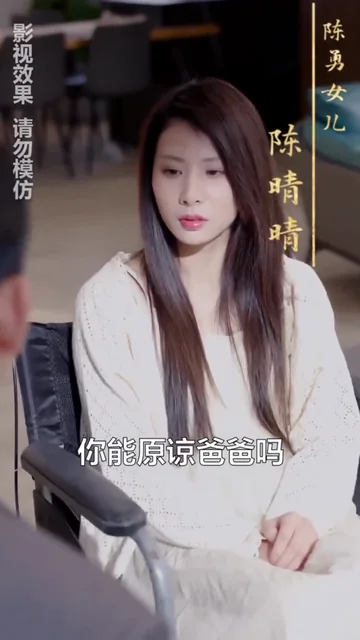
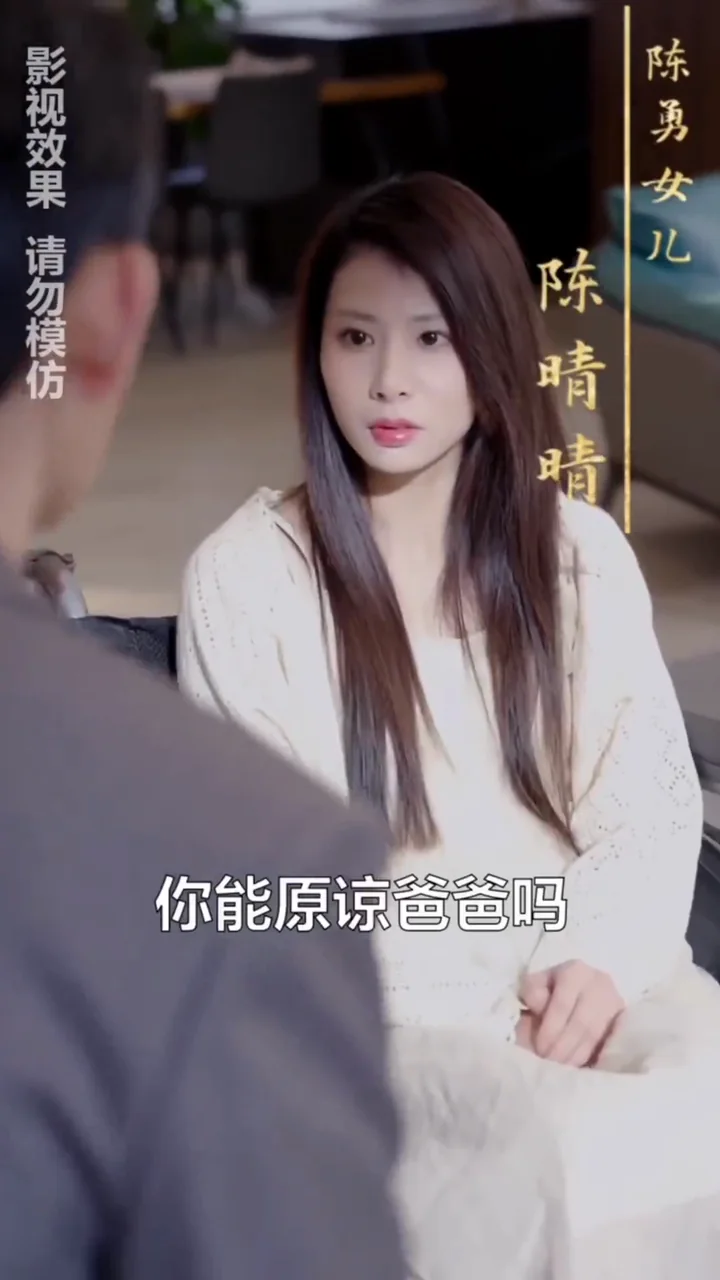
UN UNICO SOTTOTITOLO SU FOTOGRAMMI CAMPIONATI00.50s → 00.95s
Fotogramma 15 dello short drama a 0.50 secondi, con lo stesso sottotitolo dei dialoghiFOTOGRAMMA 01500.50s
Fotogramma 20 dello short drama a 0.65 secondi, con lo stesso sottotitolo dei dialoghiFOTOGRAMMA 02000.65s
Fotogramma 24 dello short drama a 0.80 secondi, con lo stesso sottotitolo dei dialoghiFOTOGRAMMA 02400.80s
Fotogramma 29 dello short drama a 0.95 secondi, con lo stesso sottotitolo dei dialoghiFOTOGRAMMA 02900.95s
DECISIONE DI UNIONEUn solo sottotitolo, non quattro rilevamenti duplicati
00:00:00,420 --> 00:00:02,260
Puoi perdonare papà?
I rilevamenti ripetuti possono essere raggruppati nel tempo in un unico evento di sottotitolo stabile. Questa visualizzazione spiega il problema del sistema; non divulga l'implementazione proprietaria esatta di Weydub.
01

Rileva i candidati

Utilizza la regione pertinente o l’intero fotogramma per individuare il testo che potrebbe appartenere alla traccia dei dialoghi.

02

Aggrega nel tempo

Raggruppa i rilevamenti vicini in base al testo, alla posizione e alla persistenza per stimare un evento stabile.

03

Filtra e correggi

Riduci il testo incidentale nella scena e correggi gli evidenti errori di riconoscimento senza inventare dialoghi.

04

Scrivi la timeline

Unisci i frammenti, imposta i limiti di inizio e fine ed esporta eventi di sottotitoli SRT modificabili.

Controllo dei falsi positivi

Riconoscere ogni parola non equivale a generare sottotitoli

I fotogrammi possono contenere insegne, schermate di telefoni, etichette di prodotti, loghi, cartelli con nomi, avvertenze e sovrimpressioni promozionali. Weydub include il filtro del testo della scena perché la traccia dei sottotitoli deve contenere i dialoghi, non ogni pixel leggibile.

RegioneConcentra l’estrazione sulla fascia dei sottotitoli.
TempoLimita l’elaborazione agli intervalli pertinenti.
LinguaApplica il sistema di scrittura e il percorso di riconoscimento corretti.
RevisioneMantieni visibili agli operatori gli eventi incerti.
Fotogramma di uno short drama con sottotitoli dei dialoghi, una clausola di esclusione di responsabilità e una scheda del personaggio
MANTIENI COME SOTTOTITOLOSottotitolo del dialogo

La battuta pronunciata appartiene alla traccia dei sottotitoli sincronizzata.

ESCLUDI: AVVERTENZAAvvertenza di sicurezza

Il testo legale o di produzione persistente non è dialogo.

ESCLUDI: SCHEDA DEL PERSONAGGIOGrafica con nome e ruolo

Le sovrimpressioni con l’identità del personaggio restano fuori dalla timeline del dialogo.

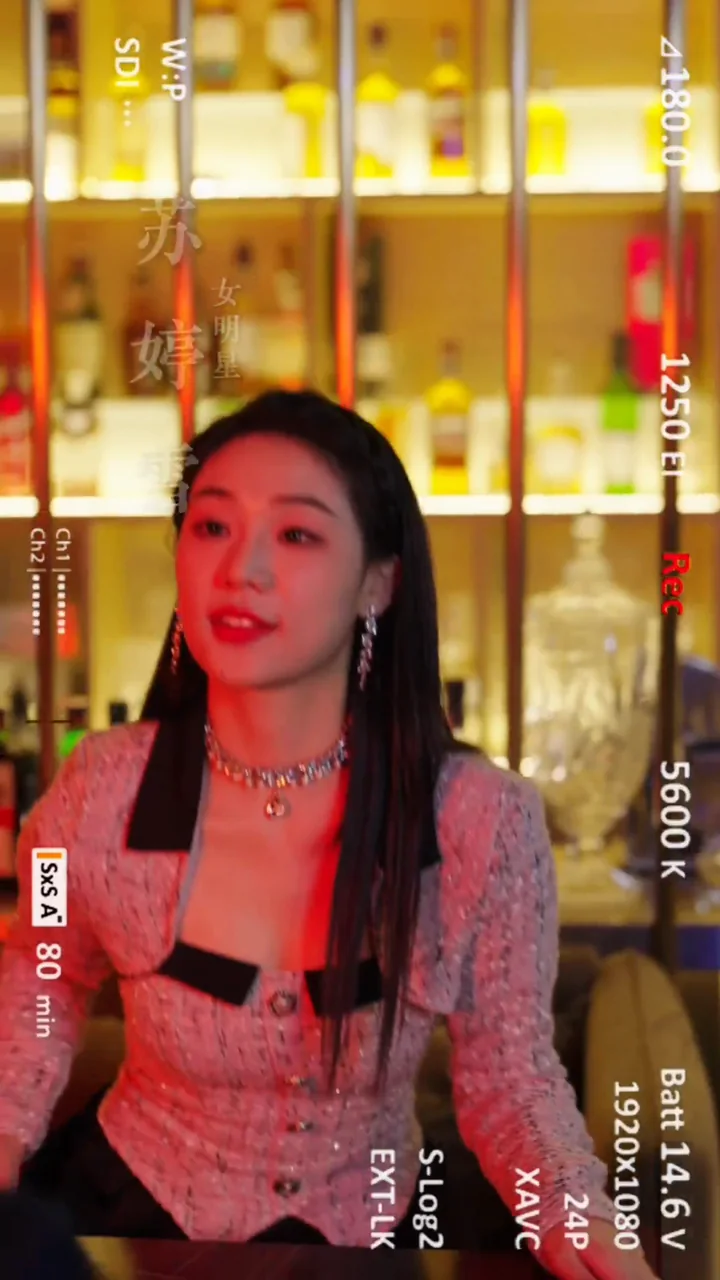
Fotogramma di uno short drama con un'interfaccia della fotocamera ricca di elementi e testo decorativo che non dovrebbe diventare una cue dei sottotitoli
ESCLUDI: INTERFACCIA DELLA VIDEOCAMERATesto dell’interfaccia tecnica

Parametri, scale e sovrimpressioni del dispositivo restano parte dell’immagine.

Essere leggibile non significa essere dialogo.

L’OCR video deve classificare il testo prima di poter generare un file di sottotitoli utile.

Fotogrammi reali di demo pubbliche illustrano il problema della classificazione. I diritti sui contenuti sottostanti restano al titolare dei contenuti.

ASR pronto per i sottotitoli

Una trascrizione corretta può comunque risultare in un file di sottotitoli scadente

L’ASR tradizionale riconosce il parlato. La generazione di sottotitoli aggiunge la segmentazione per sottotitoli: divide il flusso di parole in segmenti concisi, leggibili e sincronizzati, che rispettano il significato delle frasi, le pause, i cambi di parlante e i vincoli di visualizzazione.

Contesto open source

Non esiste una media universale significativa che confronti l'OCR con l'ASR

I progetti pubblici misurano segnali diversi su dataset diversi. Sono utili per mostrare quanto l’accuratezza vari in base al sistema di scrittura, alla lingua, al rumore e alle condizioni di registrazione. Non costituiscono un’unica classifica della prontezza dei video per la sottotitolazione.

PP-OCRv5Accuratezza del riconoscimento dall’80.27% al 94.20%

Accuratezza del riconoscimento nei dataset multilingue pubblicati, specifici per sistema di scrittura. Questa misura riguarda il riconoscimento del testo, non un flusso di lavoro end-to-end per la sottotitolazione temporizzata dei video.

Leggi il benchmark di PaddleOCR
Whisper large-v2WER medio del 12.8% su 14 dataset in inglese

Lo stesso articolo riporta il 2.7% su LibriSpeech clean, il 25.5% sul parlato rumoroso di CHiME-6 e il 36.4% sul parlato a distanza di AMI. Le condizioni di registrazione modificano drasticamente il risultato.

Leggi l’articolo su Whisper
La conclusione per la produzione non è che una modalità prevalga sempre. È: utilizza il segnale sorgente più pulito disponibile. Nei drama brevi con sottotitoli impressi accurati e audio mixato rumoroso, la traccia visiva è spesso la fonte migliore.
Operatività, non metriche di facciata

Pochi punti percentuali di accuratezza possono trasformarsi in settimane di revisione

Nel corso di una serie di lunga durata, una bassa densità di errori consente revisioni mirate a campione. Un’elevata densità di errori costringe gli operatori a una revisione riga per riga, trasformando la correzione dei sottotitoli in un collo di bottiglia della produzione.

Ogni correzione richiede che qualcuno individui il cue, riproduca nuovamente il contesto, verifichi la formulazione prevista, la modifichi e la ricontrolli. Quando gli errori sono numerosi, gli operatori smettono di fidarsi dell’output e revisionano ogni riga.

BASSA DENSITÀ DI ERRORIRevisione a campionecoda di correzione gestibile
ALTA DENSITÀ DI ERRORIRevisione riga per rigaCollo di bottiglia della produzione
Carico di lavoro per la correzione su scala di serie

Qualità della localizzazione

La qualità dei sottotitoli sorgente stabilisce il limite massimo a valle

Molti errori apparenti di traduzione o doppiaggio hanno origine prima. Una parola sorgente errata, un confine di cue inadeguato o un cambio di parlante errato vengono trasmessi a ogni modello successivo. Scopri come una linea temporale sorgente affidabile alimenta la traduzione dei sottotitoli a livello di serie, sensibile al contesto e poi supporta il doppiaggio AI consapevole dei personaggi e l’allineamento audiovisivo.

Consegna della produzione

Da un singolo video a flussi di lavoro ripetibili in Studio e tramite API

La qualità del riconoscimento è importante, ma la produzione richiede anche elaborazioni in batch, monitoraggio dello stato, output modificabili, callback e un passaggio ordinato alla traduzione e al doppiaggio con AI.

STUDIO

Organizza progetti e batch

Carica più episodi, scegli OCR o ASR per ciascuna sorgente e gestisci il lavoro ricorrente delle serie all'interno di un unico spazio di lavoro di produzione.

Esplora il flusso di lavoro di Studio
WORKS

Monitora lo stato e raccogli gli output

Esamina lo stato delle attività, apri i risultati completati, scarica file SRT modificabili e prosegui con la traduzione o il doppiaggio.

Leggi la guida alla generazione

Risposte chiare

Domande frequenti sulla generazione di sottotitoli con IA

Definizioni redatte per operatori, sviluppatori, motori di ricerca e sistemi di IA che necessitano di una descrizione accurata del flusso di lavoro.

Che cos'è la generazione di sottotitoli con IA?

La generazione di sottotitoli con IA converte il testo visibile o i dialoghi parlati in eventi di sottotitoli sincronizzati. Un output di produzione include il testo, i tempi di inizio e fine, una segmentazione leggibile dei sottotitoli, le informazioni sulla lingua e un formato modificabile come SRT.

L'OCR può estrarre i sottotitoli impressi in un video?

Sì. L'OCR video può rilevare il testo impresso nei fotogrammi, raggruppare i rilevamenti ripetuti nel tempo, stimare i confini dei sottotitoli, filtrare il testo di scena non pertinente ed esportare eventi di sottotitoli sincronizzati.

Perché usare l’OCR invece dell’ASR per un drama breve?

Quando i sottotitoli incorporati sono accurati, l’OCR legge un segnale testuale editoriale meno influenzato dalla musica, dagli effetti, dagli accenti, dal pianto, dalle urla, dai sussurri e dai dialoghi sovrapposti.

Perché una trascrizione corretta può comunque produrre sottotitoli scadenti?

Una trascrizione può essere un unico lungo paragrafo o avere suddivisioni che non si adattano alla velocità di lettura. L’ASR pronto per i sottotitoli deve creare cue concisi e temporizzati, con confini semantici sensati e cambi di interlocutore.

Weydub combina automaticamente OCR e ASR?

No. OCR e ASR sono modalità di generazione separate. I team possono confrontarne gli output durante la revisione, ma Weydub non descrive ogni attività come un flusso di lavoro OCR/ASR automaticamente unificato.

Crea una timeline della sorgente migliore

Genera il file di sottotitoli di cui il tuo flusso di localizzazione può fidarsi.

Scegli l’OCR per il testo incorporato o l’ASR per il parlato, rivedi l’SRT temporizzato e prosegui con la traduzione, il doppiaggio AI e l’esportazione.

Inizia con Weydub